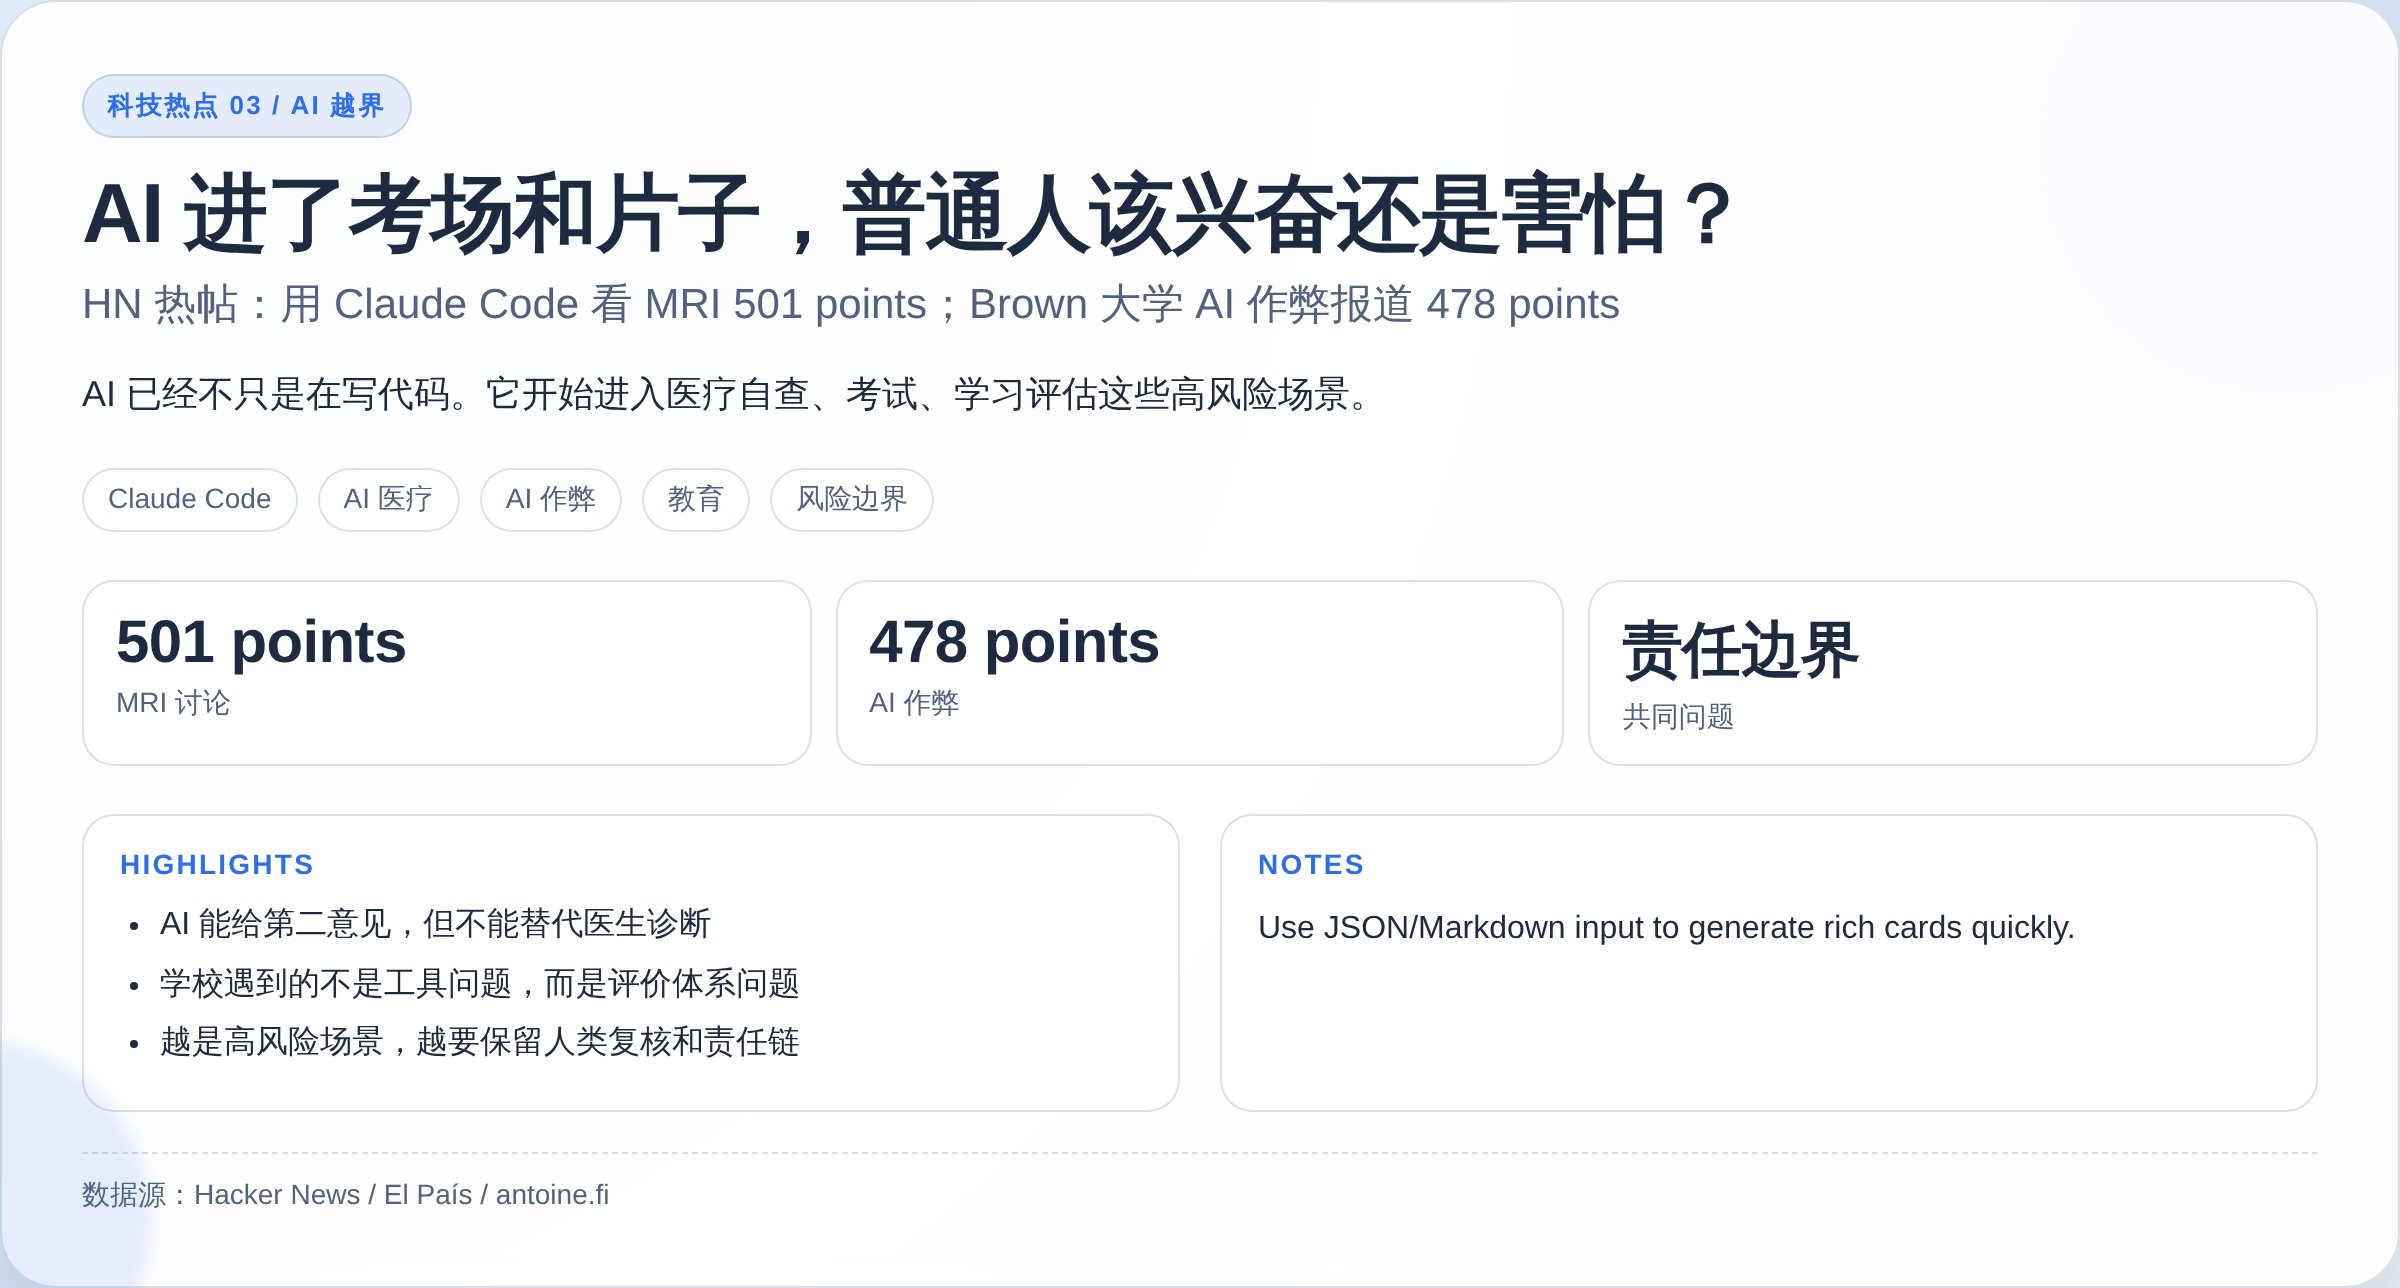
今天我看到两个 AI 热帖放在一起,感觉很微妙。
一个是有人用 Claude Code 给自己的 MRI 做“第二意见”,Hacker News 上有 501 points。另一个是 El País 报道 Brown 大学考试中出现大规模 AI 作弊争议,HN 热度 478 points。
一个发生在医疗自查,一个发生在大学考试。场景不同,但问题是同一个:AI 已经不只是帮你写东西,它开始进入需要责任边界的地方。
用 AI 看 MRI,听起来很酷,也很危险
先说医疗这件事。
用 AI 辅助理解体检报告、MRI 片子、化验单,这种需求一定会越来越多。原因很简单:普通人看不懂医学术语,排队问医生又慢,AI 至少能把术语翻译成人话。
但问题也在这里。AI 可以帮你整理问题,不能替你下诊断。它可以告诉你“报告里提到了哪些关键词”,但不能承担误判后的责任。
这类工具最适合做三件事:
- 帮你把报告里的专业词解释清楚。
- 帮你整理下一次问医生的问题清单。
- 帮你对比前后两次报告里的变化。
它最不适合做一件事:直接告诉你“有没有病、严不严重、该不该治疗”。
AI 作弊不是学生偷懒这么简单
再看 Brown 大学那个报道。很多人会把 AI 作弊理解成学生不诚实,这当然是一部分。但更大的问题是,学校原来的评价方式被打穿了。
如果一份作业只要求学生写一段标准答案,AI 很容易代劳。如果考试环境没有重新设计,检测工具也跟不上,最后就会变成老师、学生、学校互相不信任。
这不是靠一句“禁止使用 AI”能解决的。
学校真正要改的是评价方式:
- 更多现场解释和口头追问。
- 更多过程记录,而不是只看最终答案。
- 明确区分“允许用 AI 辅助”和“禁止 AI 代写”。
- 对不同课程设置不同规则,而不是全校一刀切。
为什么这两个话题会同时火
我觉得原因很简单:大家已经默认 AI 很有用,但还没想清楚哪些地方不能随便用。
写代码出错,可以回滚。写博客出错,可以修改。可医疗和考试不一样。医疗涉及身体风险,教育涉及公平和评价。一旦 AI 参与进来,责任就不能只丢给用户自己。
这也是今天这两个话题最值得写的地方。它们不是“AI 又强了”的新闻,而是“AI 已经开始进入灰区”的信号。
普通人怎么用才比较稳
我的建议很简单:
医疗场景,把 AI 当翻译和笔记工具,不当医生。
学习场景,把 AI 当教练,不当代写枪手。
工作场景,把 AI 当初稿工具,不当最终负责人。
凡是结果会影响身体、学位、合同、财务和法律责任的地方,都要保留人工复核。不是因为 AI 没用,而是因为越有用的工具,越容易让人放松警惕。
结尾
AI 的边界不会靠口号划出来。它会在这些具体场景里一点点被逼出来:能不能看病,能不能考试,能不能签合同,能不能替人做决定。
我不反对普通人用 AI。恰恰相反,我觉得会用 AI 的人会越来越占优势。但越是这样,越要记住一条线:AI 可以帮你想,不能替你负责。
资料来源
- Hacker News front page:
I used Claude Code to get a second opinion on my MRI,抓取时为 501 points - Hacker News front page:
Professor denounces mass AI fraud on an exam at Brown,抓取时为 478 points - El País:
AI fraud at Brown University: academic integrity is at risk - antoine.fi:
MRI analysis using Claude Code Opus