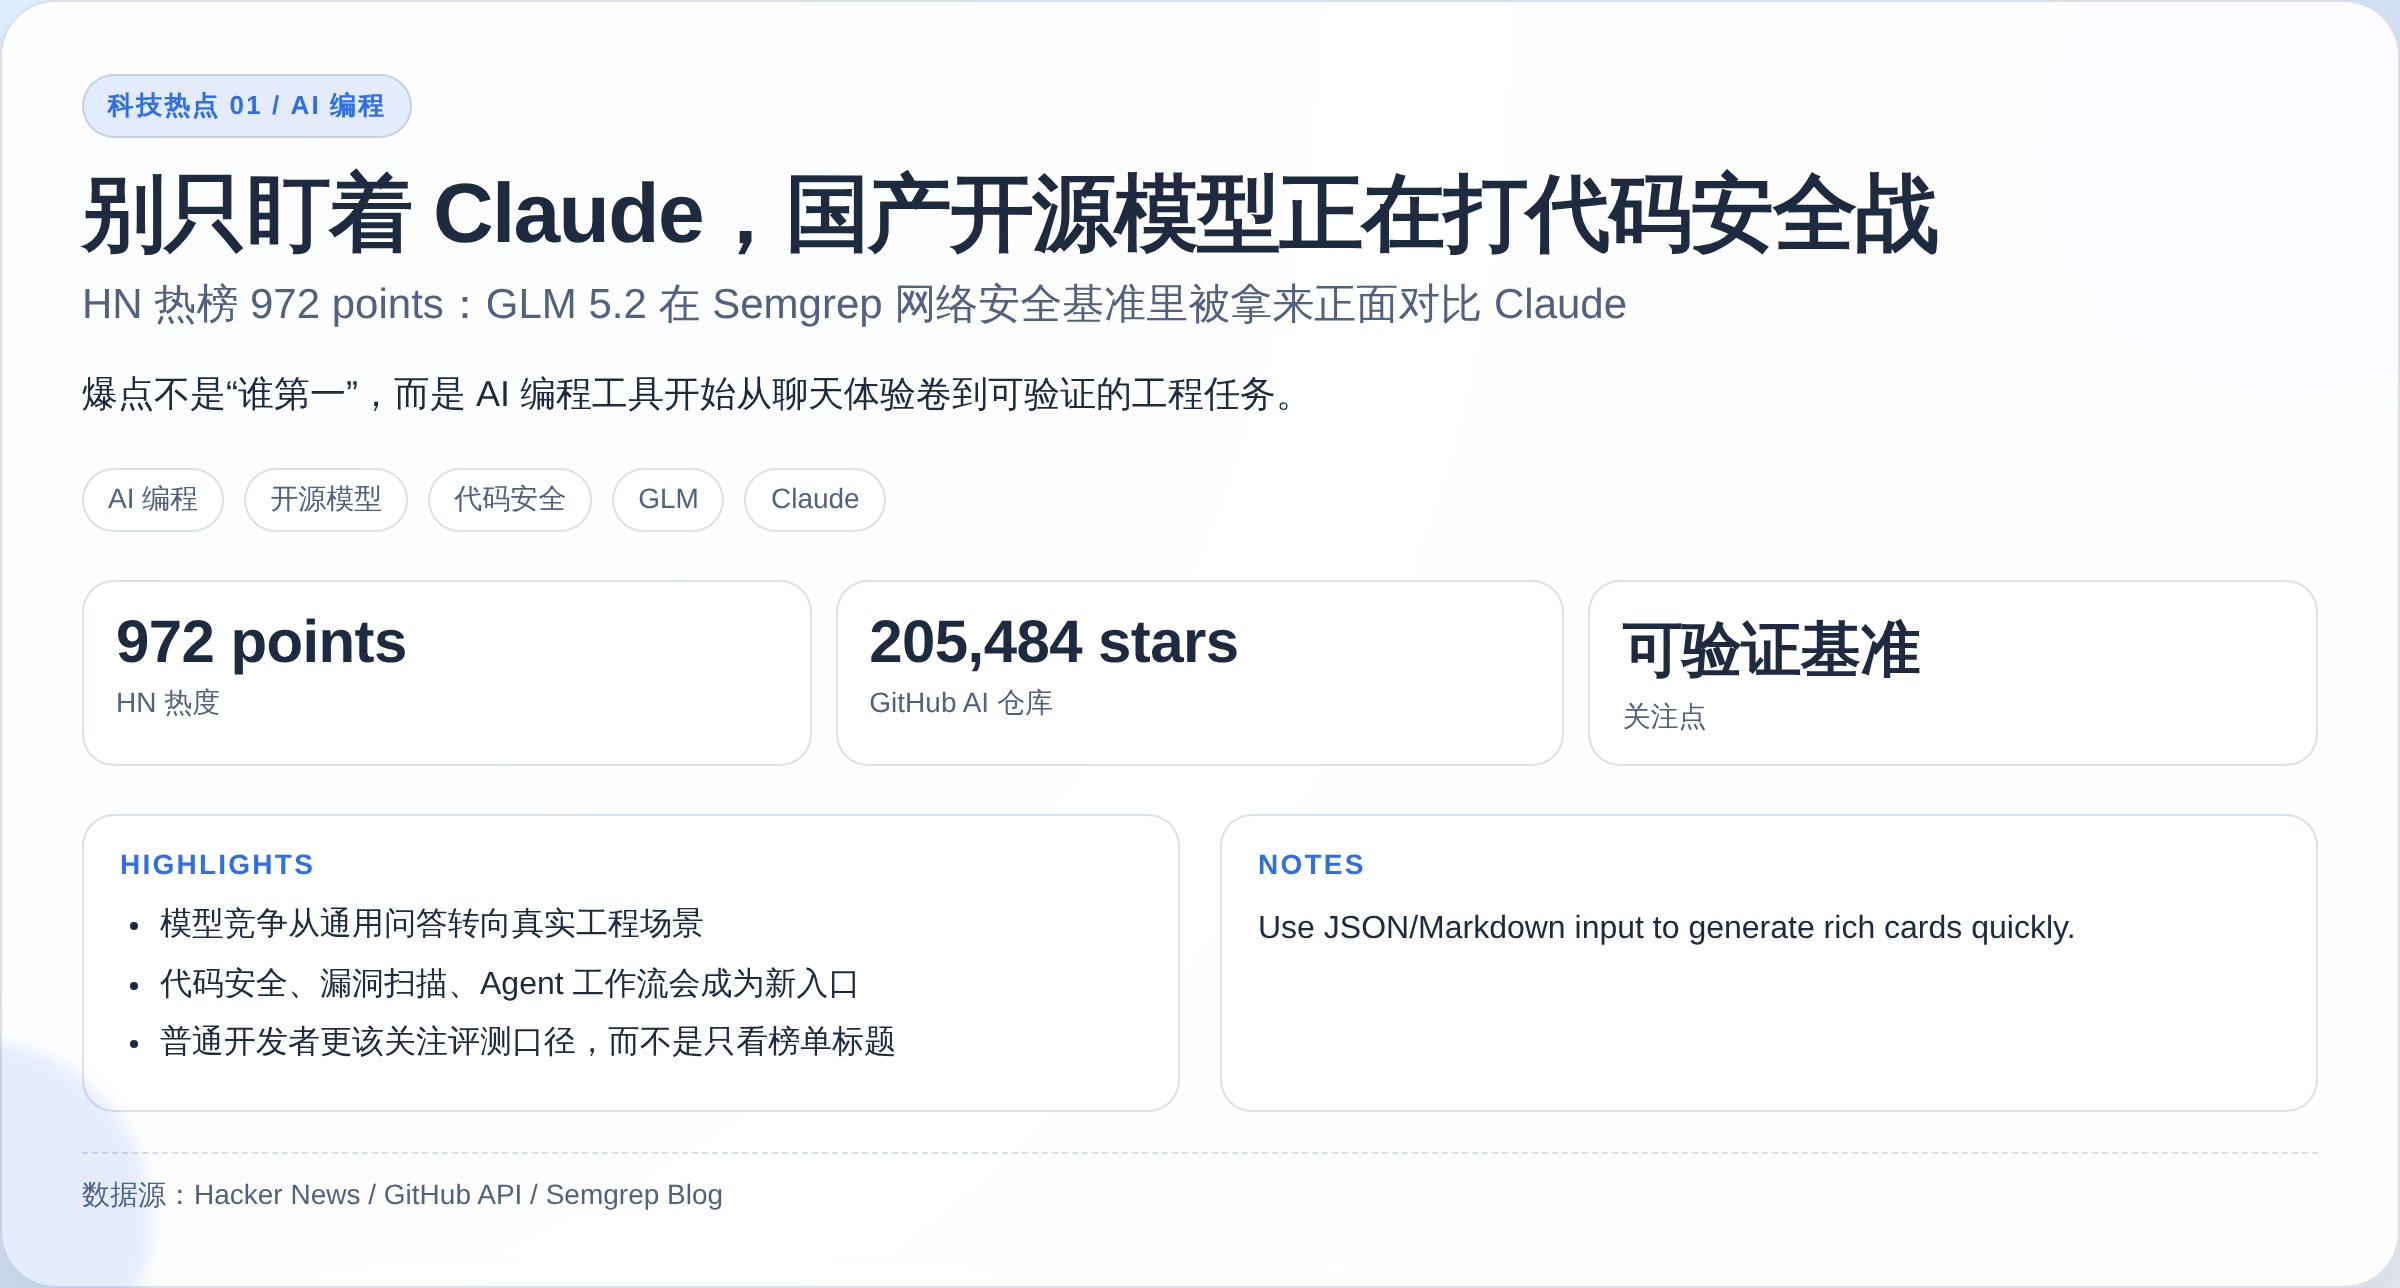
这两天技术圈最值得看的,不是某个模型又发了一个更会聊天的版本,而是 AI 编程开始往“可验证的工程任务”里钻。
Hacker News 今天有一篇文章冲到前排,标题很直接:GLM 5.2 beats Claude in our benchmarks。我看到时它已经有 972 points。同一批 GitHub 数据里,NousResearch 的 hermes-agent 仓库显示 205,484 stars,n8n 有 194,490 stars,RAGFlow 有 83,854 stars。这些数字放在一起看,信号很明显:大家已经不满足于“AI 能不能写一段代码”,而是在问“它能不能进真正的工程链路”。
这次热度为什么值得看
过去一年,AI 编程工具的卖点很像:更会补全、更懂上下文、更像一个高级实习生。但这次 HN 热帖讨论的方向更窄,也更硬。
它不是单纯比谁回答更漂亮,而是把模型放到代码安全、漏洞扫描、工程基准这类场景里比较。Semgrep 本来就是做代码安全扫描的公司,它把 GLM 5.2 和 Claude 放在自己的网络安全基准里对比,这件事本身就比普通聊天榜单更有信息量。
我更关心的是这层变化:
- AI 编程正在从“写 demo”转向“跑真实任务”。
- 模型能力开始被安全、测试、审计这类工程指标约束。
- 开源模型如果在垂直任务里追上闭源模型,企业的选型逻辑会变。
当然,标题里的“beats Claude”不能直接理解成“全面超过”。任何 benchmark 都要看题目、样本、评分方式和失败案例。但它能冲上 HN 前排,说明开发者已经愿意认真讨论开源模型在专业场景里的可能性。
对普通开发者意味着什么
如果你只是用 AI 写一点脚本,短期不用太焦虑。真正变化的是团队级工具链。
以前一个开发团队买 AI 工具,常见问题是:这个模型会不会写代码?现在问题变成了:它能不能接进 CI?能不能解释安全告警?能不能把修复建议变成 PR?能不能留下审计记录?
这也是为什么 GitHub 上 AI 工具类仓库很容易涨 star。n8n、RAGFlow、Hermes Agent、Haystack 这些项目看起来方向不同,但底层需求很接近:把模型接到流程里,让它干活,而不是只聊天。
但别只看榜单
我建议看这类新闻时,别急着站队。更好的看法是问三个问题:
- 这个 benchmark 测的是什么任务?
- 失败样本有没有公开?
- 结果能不能复现到我的工作流?
AI 编程下一阶段的分水岭不在“谁会说”,而在“谁能稳定交付”。代码安全、单元测试、自动修复、PR 审查,这些才是模型真正进入工程系统的入口。
我的判断是:未来半年,AI 编程的热度会继续从“模型名字”转向“工作流能力”。谁能把模型、工具、权限、日志和回滚串起来,谁就更接近真正的生产力。
资料来源
- Hacker News front page:
GLM 5.2 beats Claude in our benchmarks,抓取时为 972 points - Semgrep Blog:
GLM 5.2 beats Claude in our cyber benchmarks - GitHub API:NousResearch/hermes-agent 205,484 stars,n8n-io/n8n 194,490 stars,infiniflow/ragflow 83,854 stars