从手工发布到 API 自动化:把内容管理沉淀成可复用能力
在内容站点的日常维护中,发布文章、上传配图、保存草稿、修改标题和补充分类这些动作看起来并不复杂,但一旦频率变高,就会逐渐变成重复劳动。更麻烦的是,手工流程通常依赖后台页面和个人习惯,很难复用、审计和自动化。
EMLOG 提供的 API 能力,正好可以把这些操作从“点页面”转成“调用接口”。当站点管理动作变成可描述、可验证、可复用的流程后,内容生产就不再只是后台操作,而可以成为自动化工作流的一部分。
为什么要把发布流程 API 化
传统后台发布适合低频操作,但在以下场景中会遇到明显瓶颈:
- 文章来自多个来源,需要统一入库为草稿。
- 配图、封面和正文需要在发布前自动处理。
- 希望保留每次发布的参数、返回结果和失败原因。
- 同一套内容要在测试站、正式站或多个栏目之间迁移。
- AI 辅助写作后,需要直接落到草稿箱等待人工复核。
API 化并不是为了绕过审核,而是为了把机械步骤交给程序,把判断和质量控制留给人。
一个实用的自动化发布链路
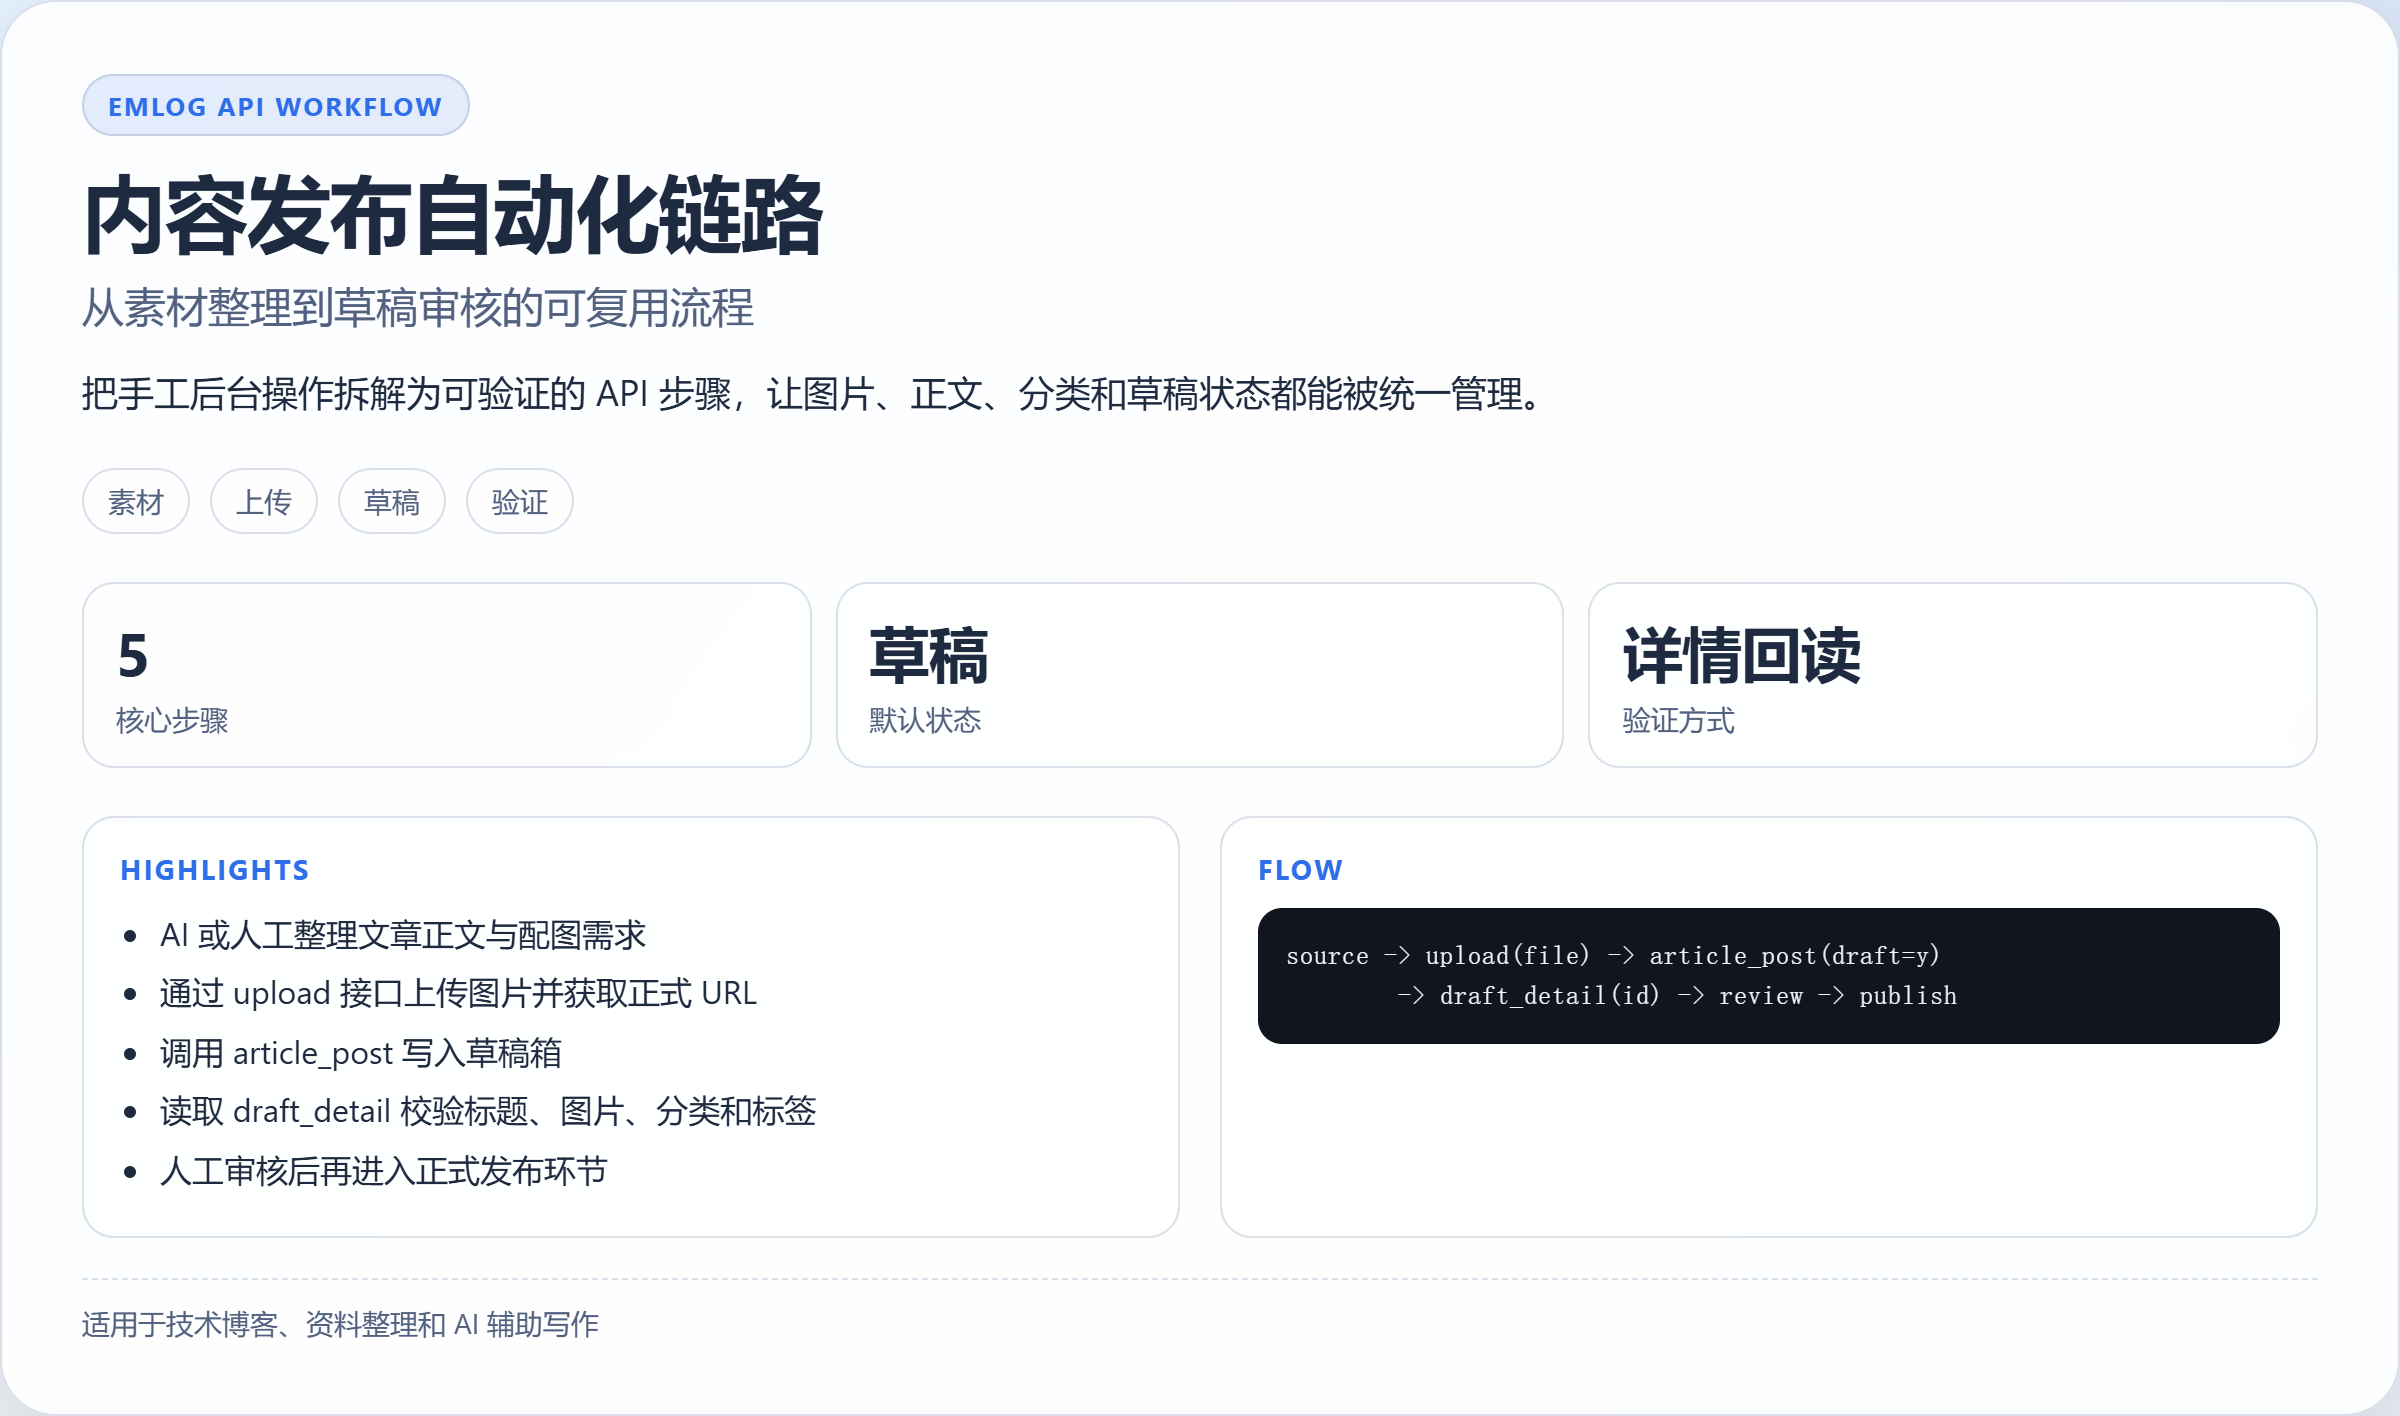
一个稳定的 EMLOG 内容发布链路通常可以拆成四步。
第一步是站点配置。站点地址、鉴权方式和 API 密钥需要有明确来源。推荐优先使用环境变量保存 API 密钥,例如 EMLOG_API_KEY;如果当前环境无法配置环境变量,也可以把密钥记录到本地忽略文件中,避免每次重复输入。
第二步是资源上传。正文中的图片先通过 upload 接口上传到站点或 CDN,拿到正式 URL 后再写入 Markdown。这样文章草稿在后台预览时就能看到真实图片,而不是依赖本地文件路径。
第三步是文章生成。标题、正文、摘要、分类、标签、封面和草稿状态都应该作为参数传入。对技术文章来说,建议默认写入草稿箱,由人工检查代码块、图片、链接和格式后再发布。
第四步是结果验证。接口返回成功并不代表内容完全符合预期,仍然需要通过草稿详情接口读取一次,确认标题、正文、图片和草稿 ID 都正确落库。
鉴权设计要点
EMLOG API 支持签名鉴权。常见做法是用当前 Unix 时间戳和 API 密钥拼接后计算 MD5:
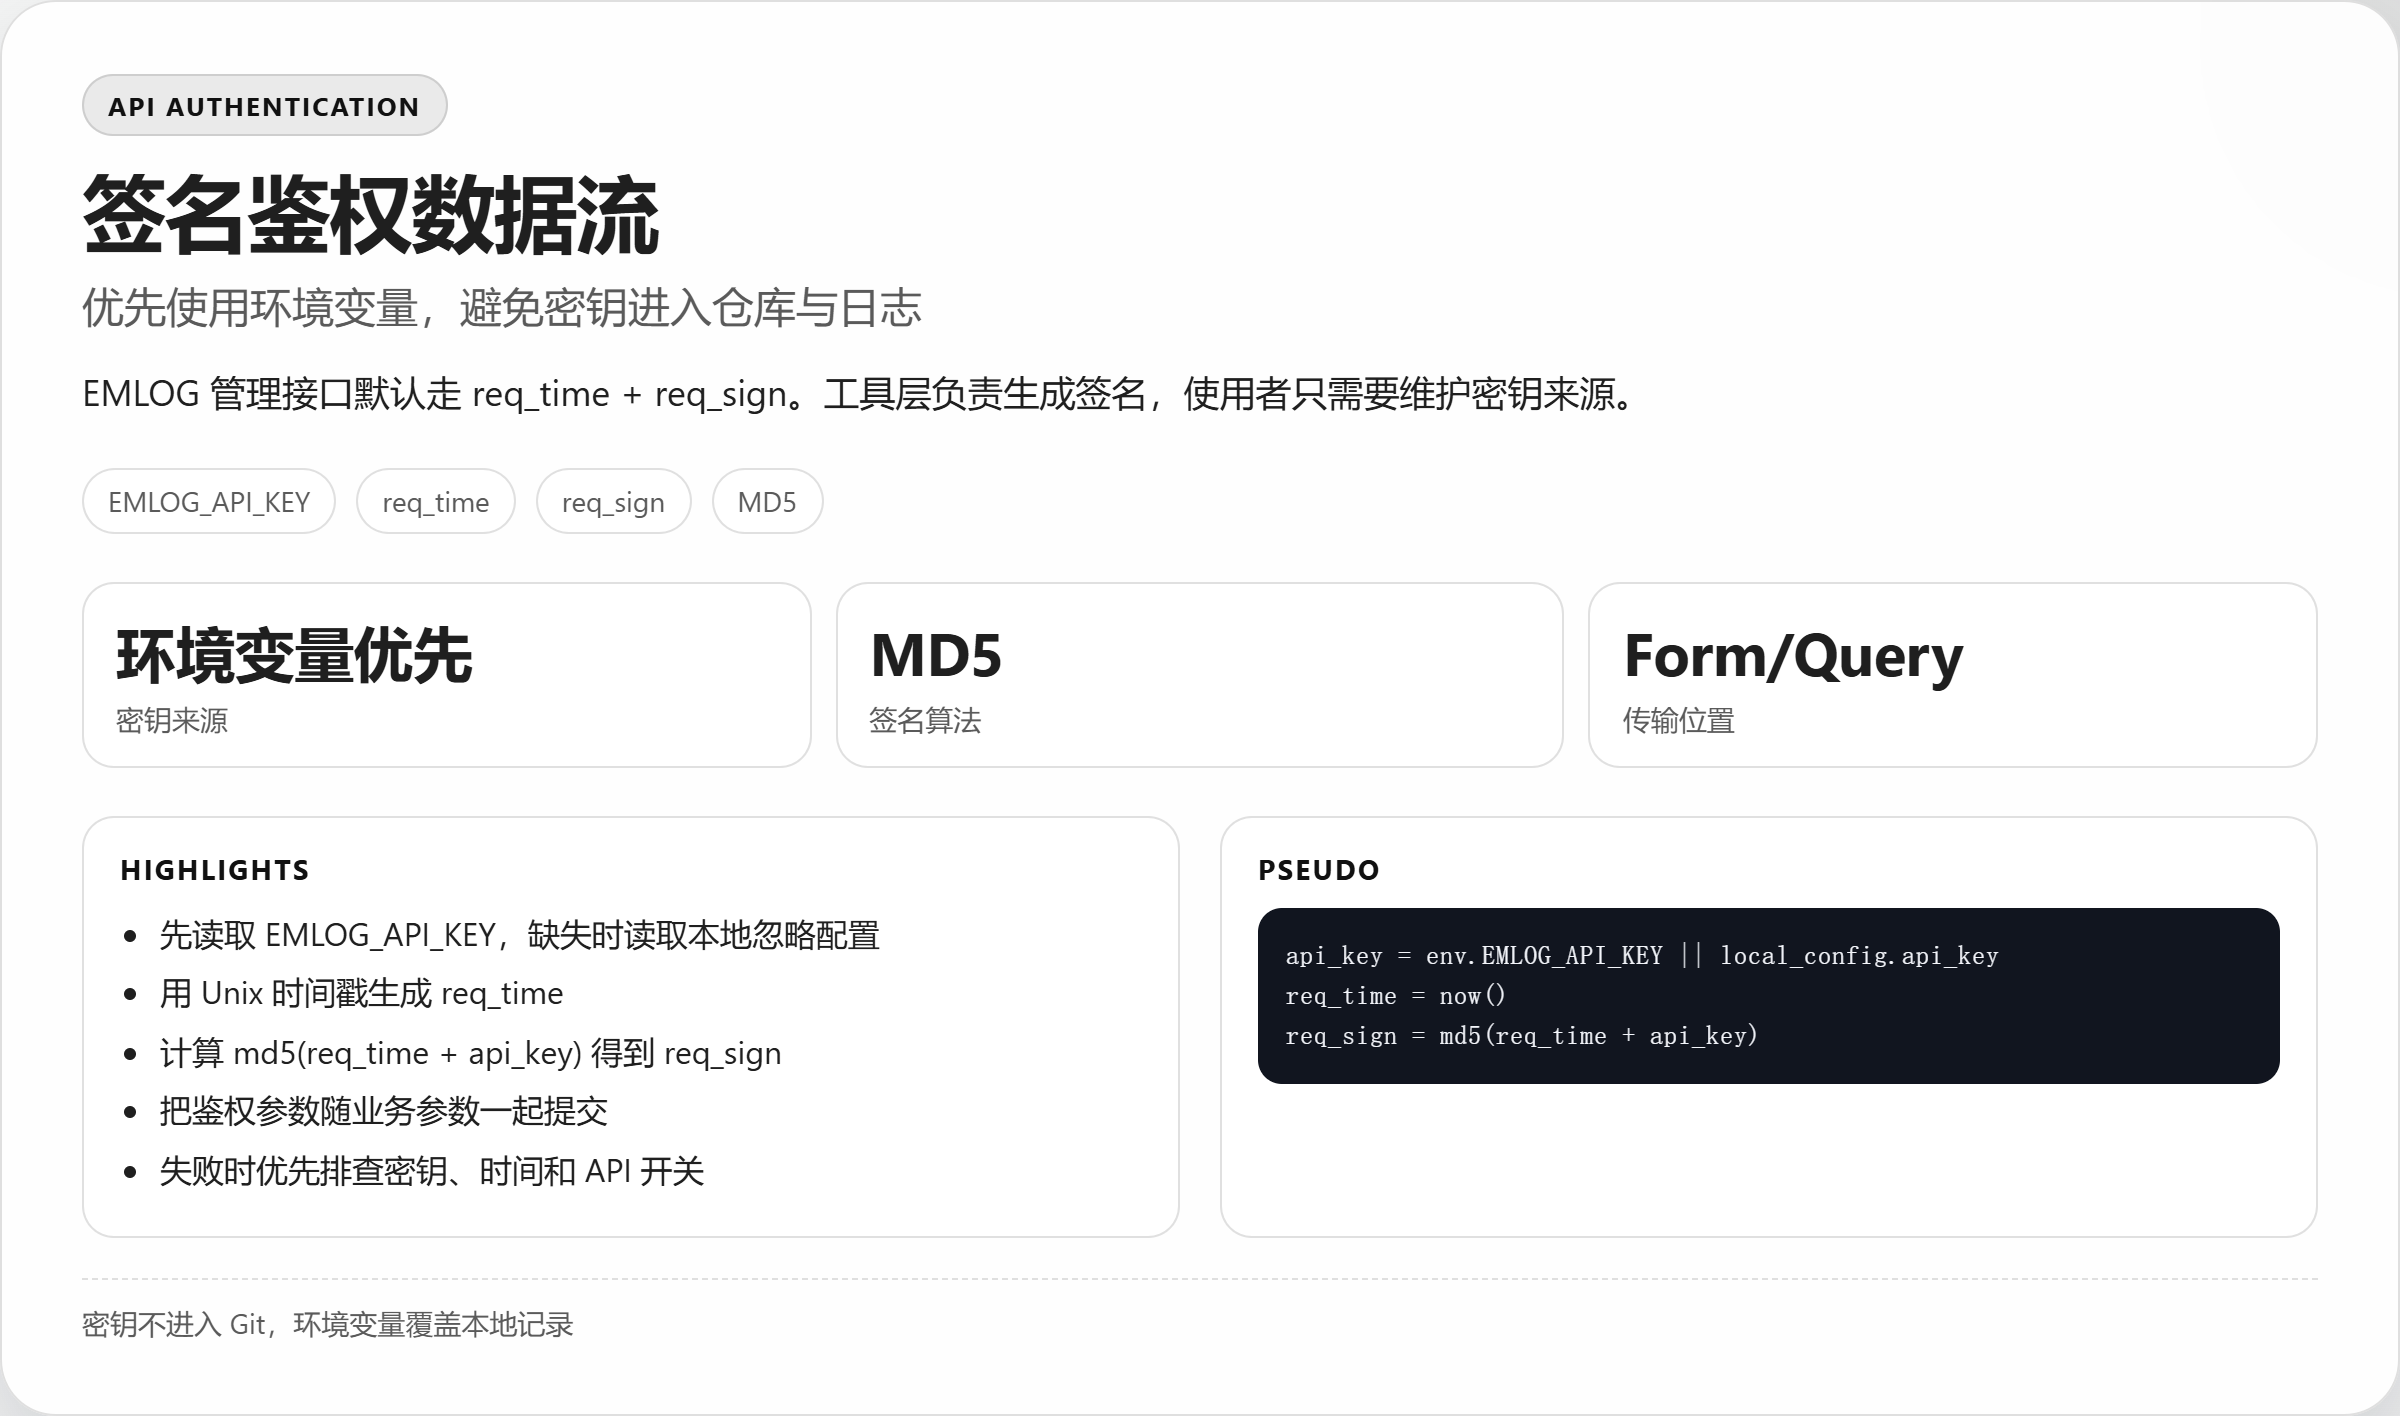
req_sign = md5(req_time + api_key)这种方式比直接传递 api_key 更适合作为默认方案。实现时要注意三点:
- 本机时间不能和服务器时间偏差过大。
- API 密钥不要写入仓库或公开日志。
- 环境变量应优先于本地配置,方便在不同运行环境中切换密钥。
失败处理比成功调用更重要
自动化流程真正可靠,关键不在于“能成功一次”,而在于失败时能快速定位原因。EMLOG API 常见错误包括:
sign error:通常是密钥错误、签名算法错误或时间戳异常。api is closed:后台没有开启 API 功能。API function is not exist:接口名错误,或站点版本不支持该接口。parameter error:缺少标题、正文、文章 ID 等必填参数。
这些错误都应该在工具层直接翻译成可执行建议,而不是只把原始报错丢给使用者。
推荐的落地原则
对于个人站点或团队内容系统,可以按以下原则推进:
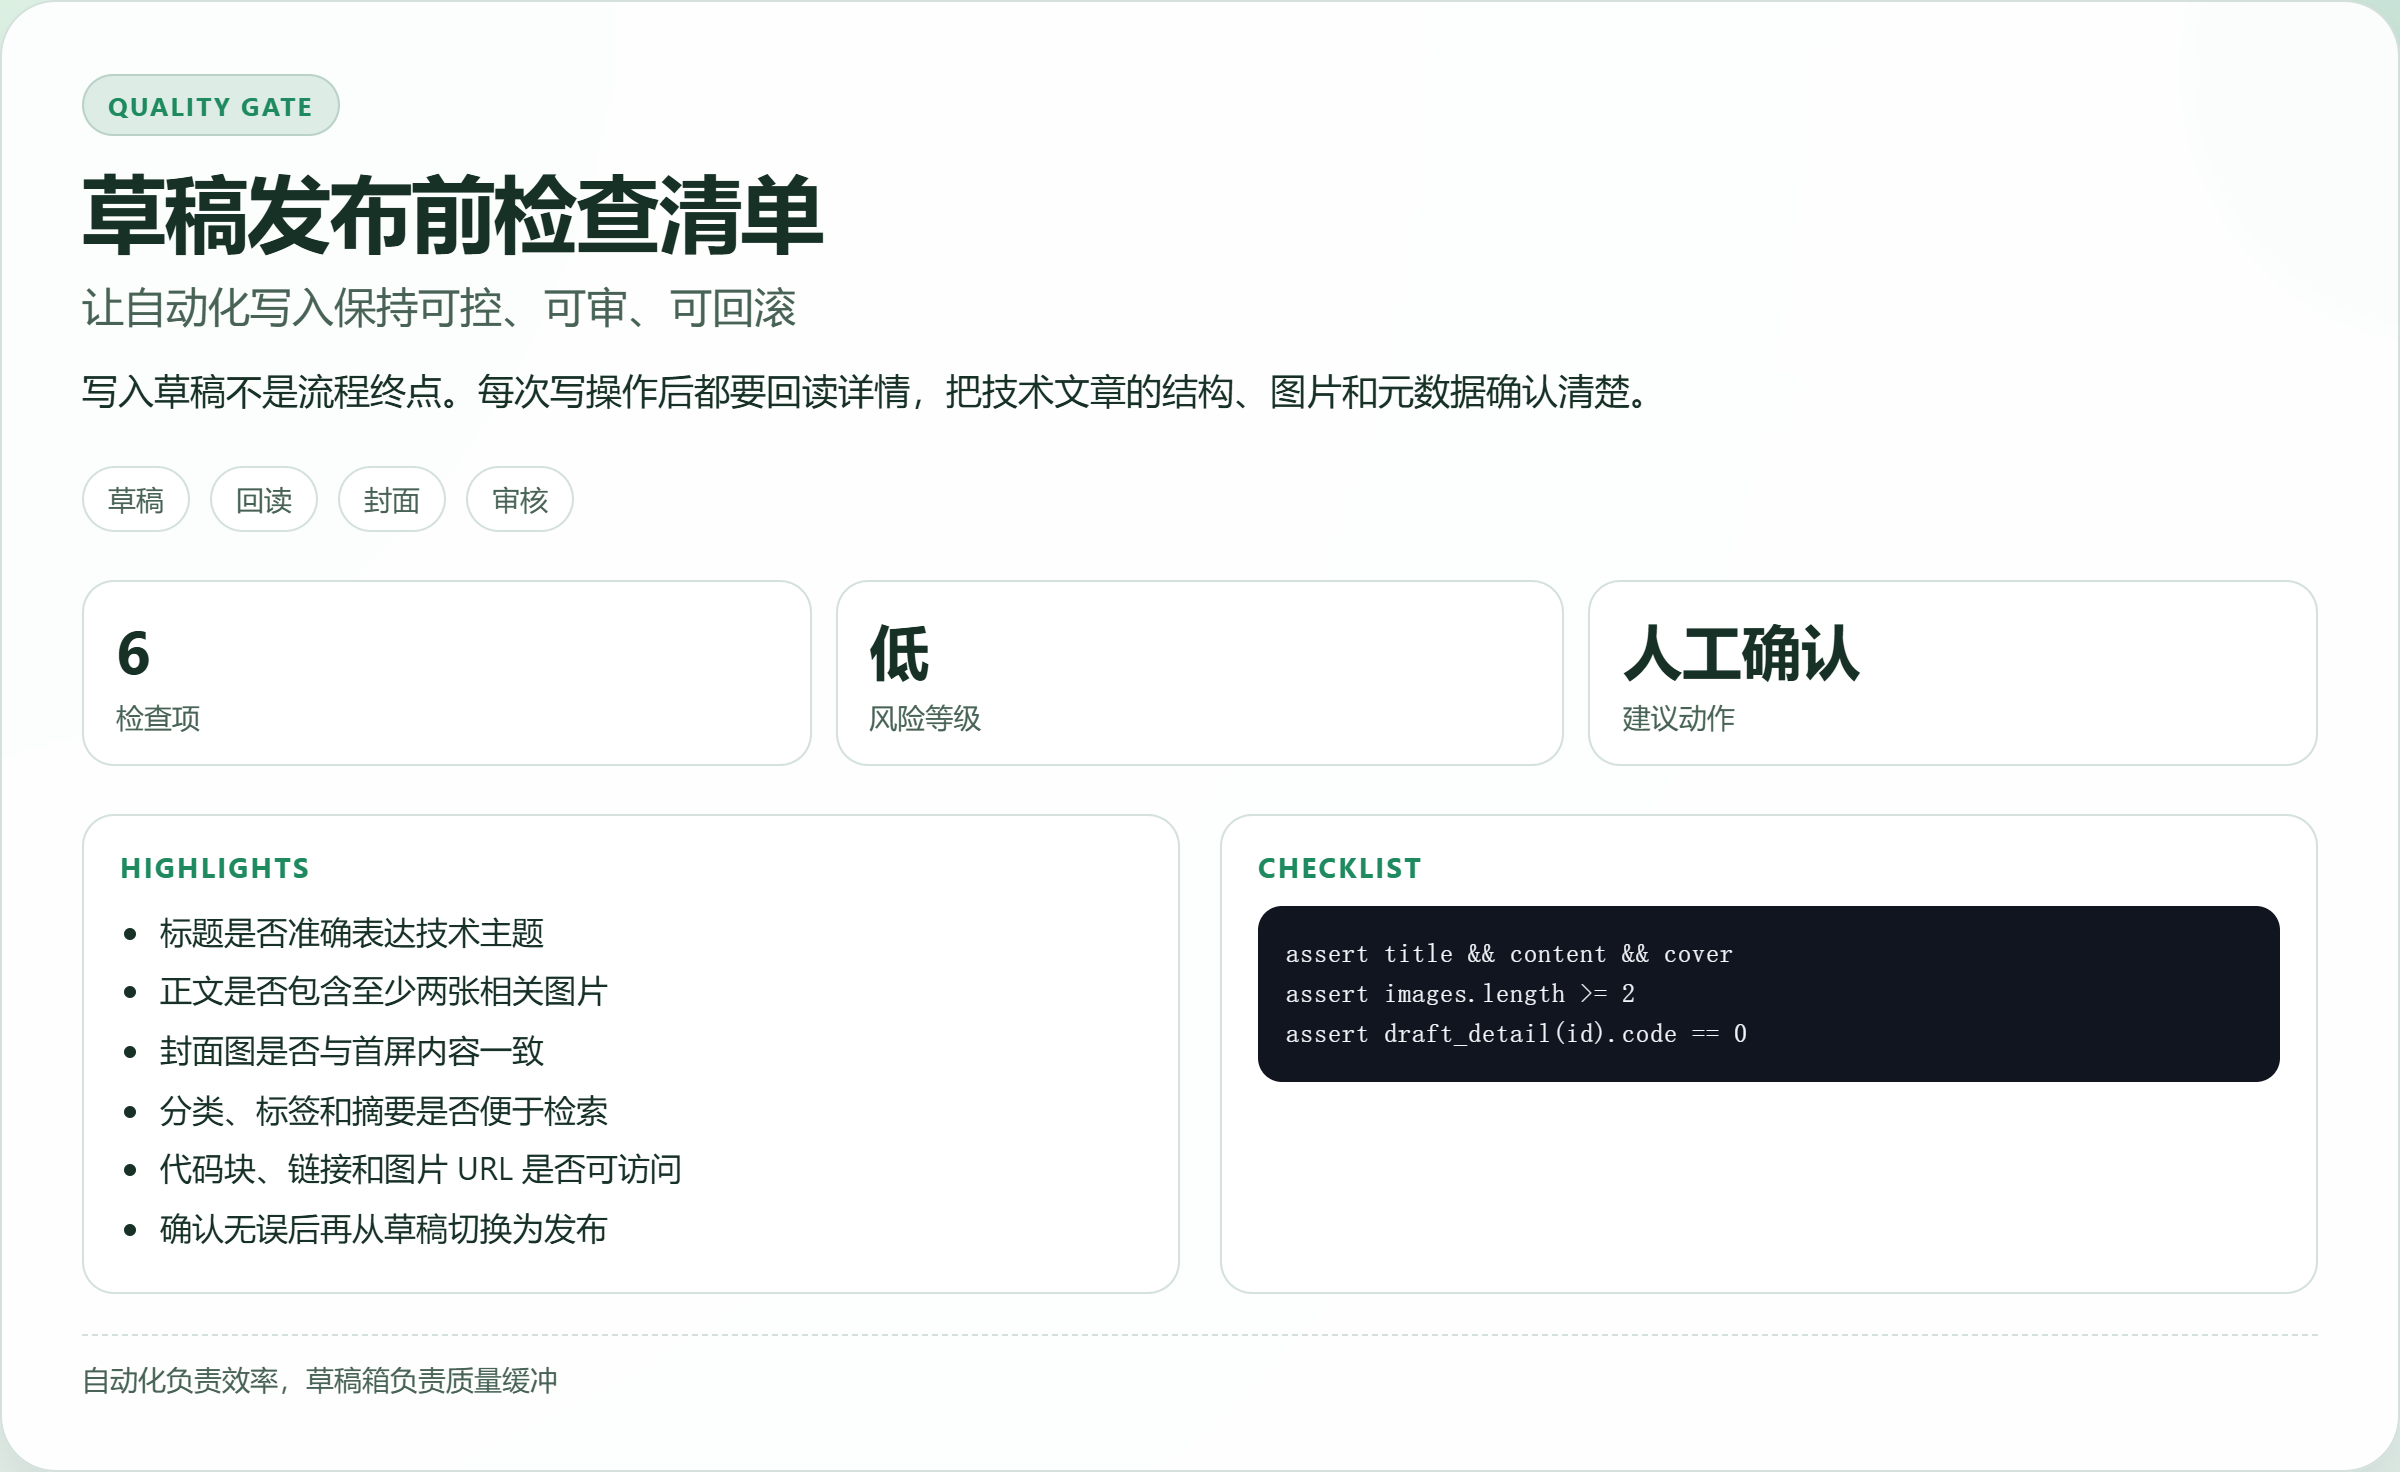
- 先从只读接口开始,例如分类列表、文章列表和草稿详情。
- 再接入低风险写操作,例如上传图片和写入草稿。
- 发布正式文章前保留人工确认环节。
- 所有密钥进入环境变量或本地忽略配置,不进入 Git。
- 每次写操作后都读取详情接口做二次验证。
结语
内容管理自动化的价值,不只是节省几次点击,而是把发布流程变成一套稳定、可复用、可审计的能力。对技术博客来说,这种能力尤其适合承接 AI 辅助写作、资料整理、批量迁移和多平台分发等任务。
当 API、脚本和清晰的流程约定组合起来,站点后台就不再只是一个手工操作界面,而会变成内容生产系统的一部分。